如何让 Coding Agent “吃”点好的上下文?
文章目录
本文由我的技术分享整理为公开版。示例中的 agent 命令、.agent/ 目录和工具名用于说明设计思路,不代表某个产品的实际接口;具体加载、缓存和压缩行为应以所用工具的实现为准。
现在写代码不用 Agent,反而显得有点“原始”。
但很多人用 Coding Agent 时,心里都会吐槽:
- 🐢 慢:问个很小的改动,转啊转半天不回
- 🥴 笨:上下文塞了一大堆文档和代码,它还是理解错
- 👻 爱“幻觉”:信誓旦旦给你一坨实现,跑起来直接报错
除了模型智能的上限,还在于我们:
不了解它在执行任务时 究竟把什么东西塞进了上下文,
也不知道 模型 + 工具 + 人是怎么靠 Prompt Cache / 上下文布局 / 工具设计 / 人类参与 一起工作的,
更不知道怎么利用这些机制 减少幻觉、提升生产效率。
这篇文章,我会以 Coding Agent 为例,从底层往上拆:
- Transformer 为什么只能“一个 token 一个 token”吐?
- Prompt Cache / KV Cache 到底在干嘛?
- 一个
agent "任务"背后,模型真正看到的 Prompt 是什么样的? - 上下文为什么不能乱塞,为什么要压缩、要 snapshot、要 AGENTS.md?
- Coding Agent 内置的工具(文件读写 / bash / 搜索 / webfetch)怎么决定它的“能力边界”?
- 好的工具应该长什么样:健壮、会分页、会给清晰反馈,还帮模型“看见红线”?
- Skill 和 MCP、Sub Agent 有什么本质区别,分别适合干什么?
- Sub Agent 怎么用来做并行 Explore / 方案论证?
- AskUserQuestion(HIL)怎么把“我不确定,先问人”变成一等公民,从源头减少幻觉?
- 最后,如何用
.agent/把这些变成可复用的工作流甚至“插件”。
唯快不破 —— 从 Transformer 原理到 Prompt Cache
1.1 为什么是一个 token 一个 token 吐?
大部分 LLM 本质都是一个「下一个 token 预测器」(扩散模型不是这种方式):
给定前面所有 token,预测下一个 token。
形式上可以写成:
这就是所谓的自回归分解(整句话出现的概率,可以分解成每个 token 在当前上下文出现的概率):整段文本的联合概率,被拆成了很多个“按顺序一个个生成”的条件概率因子:
- :在已经看到前面所有 token 的前提下,第 个 token 取某个值的概率
训练的时候,模型在做的事就是:
对每个位置 ,让真实的 的对数概率 尽量大(最小化交叉熵损失)。
推理的时候,就是不断地:
- 给定前缀 喂进模型
- 让模型输出一个分布
- 从这个分布里选出下一个 token(argmax / 采样),继续往后接
所以“一个 token 一个 token 往外吐”,不是模型故意装神秘,而是训练目标和建模形式本身就是这样的。
1.2 用一段 PyTorch 把推理循环“摊开给你看”
下面这段代码,就是一个完全不带缓存优化的最朴素自回归生成循环:
import torch
# 假设已经有一个加载好的自回归语言模型# model: (input_ids) -> logits# tokenizer: 文本 <-> token id
# 1. 准备初始输入prompt = "写一个简单的 React 组件:"input_ids = tokenizer.encode(prompt, return_tensors="pt")
# 2. 循环生成后续 tokenmax_new_tokens = 50# 开始推理模式model.eval()
for step in range(max_new_tokens):    with torch.no_grad():        # 前向传播:把“当前的所有 token 序列”丢进模型        # 注意:每一步都要重新计算“到目前为止的全部上下文”        outputs = model(input_ids=input_ids)
        # 只关心最后一个位置的 logits (代表“下一个 token”的预测依据)        next_token_logits = outputs.logits[:, -1, :]
        # 选取概率最大的 token        probs = torch.softmax(next_token_logits, dim=-1)        next_token_id = torch.argmax(probs, dim=-1, keepdim=True)
        # 把新 token 拼回输入,作为下一轮的输入        input_ids = torch.cat([input_ids, next_token_id], dim=-1)
        if next_token_id.item() == tokenizer.eos_token_id:            break
两个关键点:
- 每一步都把“当前全部 token 序列”重新丢进模型
- 第 1 步:算
prompt - 第 2 步:算
prompt + 第1个新 token - 第 3 步:算
prompt + 前2个新 token - ……
- 每一轮都在重复计算前面 90% 一模一样的东西 ——
上下文越长,重复计算越离谱。
这就是为什么你在 Coding Agent 里塞了一大坨 System Prompt + 代码 + 文档,再问一个很短的问题,GPU 依然要“转很久”:
它在每轮推理时都要把这坨上下文重新“咀嚼”一遍。
1.3 Transformer + KV Cache:Q/K/V 到底在干嘛,为什么“追加”便宜?
先看一句话:
「我昨天买了一本书,它很好看。」
当模型在处理“它”这个 token 时,本质上是在做一件事:
“我现在说的这个『它』,到底指的是前面哪一坨东西?是『书』,还是别的啥?”
在 Self‑Attention 里,这件事可以抽象成一套 “Q / K / V” 的流程:
- Q(Query)= 当前 token 想问的问题
对“它”来说,Q 里带着的潜台词大概是:
- “在我出现之前的上下文里,有哪些词可以当『我指代的对象』?”
- K(Key)= 每个历史 token 提供的一句自我介绍(标签)
比如前面这些 token 的 K 可能会给出信息:- “我是一条时间状语(昨天)”
- “我是个名词,而且是『书』”
- “我是人称代词(我)”
- V(Value)= 每个历史 token 的详细内容
也就是它真正能贡献出来的语义信息:- 这本“书”到底是什么东西
- “我”是谁
- 这句话的情感语气等等
整个 Self‑Attention 做的事情就是:
你(当前 token 的 Q)拿着问题,
看一圈所有人的标签(K),决定“我应该重点听谁”,
然后按这个权重,从这些人那里抽取详细内容(V),
把这些内容混在一起,形成你这一时刻的语义表示。
如果用一句“工程版”话概括一下:
- 用当前 token 的 Q 和所有历史 K 做一轮打分(点积 + softmax),得到一组注意力权重 ;
- 用这些权重对所有历史 V 做加权求和,得到当前位置的输出向量 。
这个过程在每一层都会重复一遍,所以前面 token 的信息会一层层“流动”和“重编码”到后面的表示里。
那 KV Cache 在干嘛?
你可以把每个历史 token 的 Key / Value 想象成两张已经整理好的“小卡片”:
- K 卡片:这家伙的“标签”(大概是什么角色、能匹配什么问题)
- V 卡片:这家伙的“内容”(真正的语义细节)
对于已经处理过的历史 token,它们的 K/V 一旦算出来,只要你不改前面的文本,就可以 一直复用——没必要每次生成新 token 都从头算一遍。
于是推理时会分成两步:
prefill 阶段(首轮把 prompt 丢给模型那一下)
- 把整段 prompt 跑一遍,给每个 token 算出 K/V,小卡片存进 KV Cache。
decode 阶段(后面逐 token 生成) - 每来一个新 token,只需要给它算一次 Q/K/V;
- 然后用它的 Q 去和“缓存里的所有历史 K/V 卡片”做 Attention 即可。
所以就有了那条关键结论:
- 在末尾追加内容,很便宜
- 老的 K/V 小卡片全部复用;
- 只为新 token 算一次 Q/K/V,再和缓存做 Attention;
- 增量成本很小。
- 改前缀 / 改中间,很贵
- 你改了第 5 个 token,它自己的表示会变,它的 K/V 也会变;
- 后面第 6、7、8… 个 token 原来是基于“旧的 K/V”算出来的,现在全都不对了;
- 实际上需要从这个修改点开始往后,把后面所有 token 的层输出重新算一遍,之前的那部分 KV Cache 等于废掉。
所以各家推理服务在工程上都在配合这件事:
- ✅ 尽量只在末尾追加(append);
- ❌ 尽量不要改前缀 / 插中间 / 中途删除一大块。
而你在后面看到的这些设计——
- 用 snapshot / Spec 来替换长历史而不是随意剪中间;
- 用 sub‑agent 重新开一条干净的 Session;
- 不在开头塞会变的东西(时间戳 / 随机种子)——
本质上都是顺着这个物理现实在做事:
让前缀稳定,KV Cache 好复用,推理又快又便宜。
进一步了解推理和训练细节:Let’s build GPT: from scratch, in code, spelled out.
1.4 这直接决定了:Agent「敢做什么、不敢做什么」
有了 KV Cache 这个前提,就能理解上下文布局中的一条重要优化原则:
在不牺牲正确性的前提下,尽量保持可复用前缀稳定。
比如:
- 对话 / 工具结果永远是往后 append,而不是编辑前面的消息
- 不会中间随便删,而是通过“总结 / 压缩”产生一个新的短前缀
- 需要大改上下文时,干脆开新 Session(Sub Agent),重新走一条干净前缀
后面我们讲的 snapshot、Spec、Sub Agent、MCP 控制工具数量,其实都可以用这条规律来审视:
这样做,是不是更有利于命中 KV Cache、减少无谓重算、减小上下文噪音?
一次 agent "任务" 背后,模型到底看到了什么?
理解了生成模式,再看 Coding Agent 的行为就不那么“玄学”了。
例如:
agent "给 user-service 加一个 /healthz 接口,并补上测试"这行命令敲下去之后,Harness 并不是“把这句话丢给模型”就完事了,而是帮你构造了一整坨 Prompt,大致包括:
1. 系统级指令(System Prompt)
- 模型服务商自带的系统提示词(安全、合规、风格等)
- Agent 在此基础上加一层:
- 你是一个 Coding Agent
- 有哪些工具可以使用
- 做事的方式和风格
- 不要乱删文件、不要写危险命令……
2. 项目级配置(AGENTS.md / 项目宪法)
- 仓库根目录下的
AGENTS.md或类似文件,里面写着:- 技术栈(React / Node / Go / …)
- 代码风格(错误处理、日志、命名约定)
- 禁止触碰的目录 / 模块
- 如何运行测试、如何打包等等
- 这一块被放在 Prompt 的头部,高优先级、尽量稳定,便于 Prompt Cache 复用。
3. 项目上下文(Project Snapshot)
- 当前用户在那个工作目录
- 选中了哪些文本
- …
4. 会话历史(Conversation & 工具调用)
- 几轮跟 Coding Agent 的对话
- 之前某次任务的总结 / snapshot
- 调用工具的请求与返回(读过哪些文件,跑过什么命令)
5. 工具定义(Tool Schemas)
- 当前这一轮允许调用的 MCP 工具清单:
- 每个工具的名称
- 一两句自然语言说明
- 输入参数的 JSON Schema
所有这些一起被拼成一个 Prompt,喂给模型。
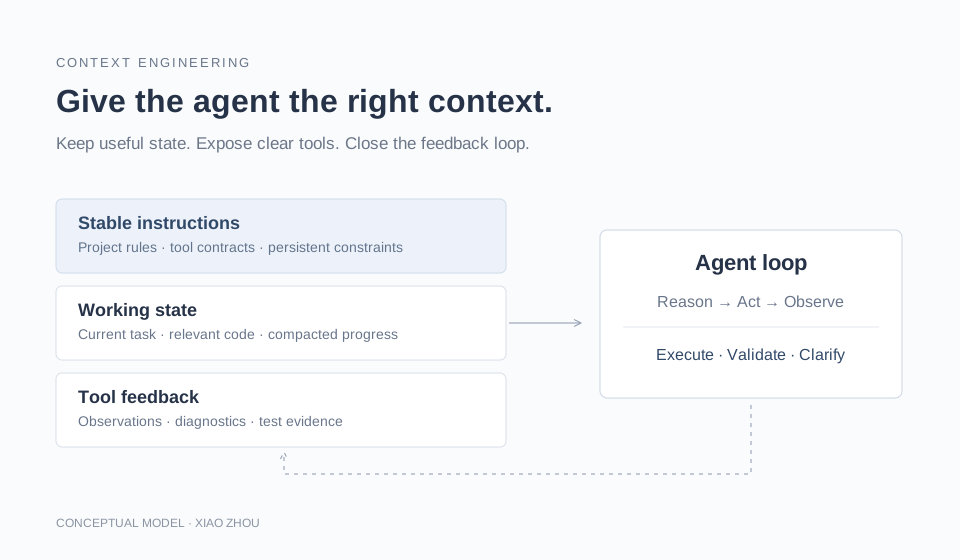
所以,上下文不是“越多越好”,
而是要“把最重要的东西放到最该放的位置”。
ReAct:Coding Agent 是怎么在上下文里“想 + 行动”的?
只讲上下文还不够,要把 ReAct 也讲清楚——这是 Coding Agent 和纯聊天最大的区别。
这里的 ReAct 是 Reason + Act 的意思,
和前端的 React 不是一个东西⚛️。
典型的 ReAct 循环长这样(逻辑上):
- Observation:
- 当前用户输入 + 历史对话 + 工具输出 = 当前“世界状态”
- Reason(思考):
- 模型在上下文里“自言自语”:
- 现在要干什么?
- 下一步需要什么信息?
- 要不要先读文件 / 先查日志?
- 模型在上下文里“自言自语”:
- Act(行动):
- 决定调用哪个工具(read_file / bash / webfetch / search…)
- 生成带参数的工具调用请求
- Observation(再感知):
- 把工具返回的结果(文件内容、日志、诊断信息)追加到上下文
- 进入下一轮 Reason + Act
你在 Coding Agent 终端里看到的,其实就是一轮轮 ReAct:
用户:给 user-service 加一个 /healthz 接口,并补上测试
Agent(Reason):先找下 user-service 的代码在哪,看看路由怎么注册的……
Agent(Act):调用 read_file / search 工具
工具输出(Observation):返回相关文件内容
Agent(Reason):哦,原来这里用的是 FastAPI,那我应该……
Agent(Act):写 patch + 再跑一次 pytest
也就是说:
- Coding Agent 不是一次“问 → 一次“答”,
- 而是一串「观察 → 思考 → 调工具 → 看结果 → 再思考 → 再调工具……」的循环。
ReAct 对上下文的影响有两个核心点:
- 它会不断往上下文里追加“思路 + 工具调用 + 工具输出”
- 这就是为什么中间“过程区”容易爆炸;
- 也是为什么要 snapshot / summary / skill / sub‑agent 来收敛上下文。
- 每次 Reason + Act 都依赖稳定前缀
- System Prompt +
AGENTS.md+ 项目快照尽量固定在前面; - 这样每一轮 ReAct 调用都能吃到 Prompt Cache 的好处。
ReAct 是 Agent 的“主循环”,
而 KV Cache / Prompt 组织方式 / MCP 工具 / AskUserQuestion,
都是为了让这条循环 跑得更快、更稳、更少瞎编。
- System Prompt +
上下文不是越多越好:记忆的艺术
很多人看到“上下文 200k / 1M”就会很兴奋:
“爽,把所有文件、所有对话全丢进去,模型肯定更聪明。”
更大的上下文窗口,并不自动意味着模型能同样有效地利用其中每一段信息。相关信息的位置、重复日志、过时方案和任务本身,都会影响最终表现。
Lost in the Middle 在其测试任务中观察到:相关信息位于输入开头或结尾时,模型往往表现更好,位于中间时则可能下降。这是一种实验现象,不能直接等同于“所有模型都给头部最高注意力权重”。
工程上,我会把上下文按职责组织:稳定规则尽量保持一致,任务状态清楚可见,中间过程及时整理。具体顺序和压缩策略仍需要用自己的任务验证。
1. 三个区域:头 / 中 / 尾
在这样的 Prompt 组织方式中,基本可以分成:
- 头部:宪法区
- 模型 System Prompt
- Agent System Prompt
AGENTS.md/ 关键架构文档片段
- 中部:过程区
- 很长的聊天记录
- 多轮工具调用输出(日志、调试信息)
- 旧的、已过时的文件片段
- 尾部:短期工作记忆
- 当前这轮任务描述
- 与当前任务强相关的代码内容
- 最新的 plan / spec / todo 节选
这是一种组织上下文的方式,不是模型内部注意力的固定分区。重要约束需要在长任务中持续可见,不能只靠位置来保证生效。
2. 主动 Compaction:把“状态”封成文件,再清过程
如果你在同一个会话里长期试错、调 bug、重构,中部“过程区”很快就会膨胀。
更好的做法是:在关键节点主动 Compaction。
例子:
agent "请把我们目前关于支付模块迁移的讨论和结论,总结成一份 snapshot,写入 docs/state/payment-migration.md"Coding Agent 会让模型把当前对话 + 相关代码,浓缩成一份结构化 snapshot,比如:
- 当前系统架构
- 迁移目标 & 选定方案
- 风险点、注意事项
- 下一步行动清单
之后你可以:
- 清掉大部分历史对话
- 后续任务只需
read_file("docs/state/payment-migration.md")把这份 snapshot 拼回上下文
好处:
- 有价值的“中间状态”变成文件,可版本管理、可 review
- 对话不会无限堆积,减轻上下文压力
- 所有支付迁移相关任务都有统一“状态锚点”
3. AGENTS.md:项目的 Prompt 宪法
在支持 AGENTS.md 约定的工具中,它可以承载稳定的项目规则。需要由 Harness 明确加载这些规则,并确保压缩或任务交接后仍能保留重要约束。
具体加载位置、作用范围、子 Agent 是否继承,以及压缩后如何处理,取决于工具实现;不能把“创建了一个文件”理解为“所有 Agent 都会自动遵守”。
建议写:
- 技术栈 & 框架选择
- 代码风格 & 错误处理约定
- 安全边界(禁止做什么)
- 团队工作流(先写测试再实现、如何写 commit message …)
不要写:
- 本周活动、一次性需求、经常变动的信息
- 某次重构的临时细节目标
这些更适合放在 snapshot/spec/todo 里,而不是挂在“宪法”上。
工具:既要避免维度诅咒,又要让模型“看得到反馈”
**工具决定了模型的能力边界,**但工具不是“能调用就完事”,还要:
- 能力边界清晰(能动什么、看什么、查什么)
- 健壮(自动分页、重试、合理默认值)
- 错误反馈清晰、结构化
- 帮模型“看到”它原本看不到的东西(比如 IDE 里的语法飘红)
1. Coding Agent 内置了哪些工具?能力边界在哪?
以常见的 Coding Agent 为例,通常包含以下基础能力:
- 文件读写(File I/O)
- 列出项目文件 / 目录/ 读取文件内容
- 写回 / patch 修改文件
👉 这是它读取和修改代码的基础接口。
- 受控 bash / shell
- 执行受限命令(
npm test、pnpm lint、pytest…) - 把 stdout / stderr 返回给模型
- 👉 这是它感知“真实运行结果”的方式。
- 执行受限命令(
- 网络搜索(search)
- 带约束的搜索:技术文档、API 文档、issue、论坛等
👉 不给这个,Agent 对外部世界的认知就停在训练数据 + 你贴的那点上下文。
- 带约束的搜索:技术文档、API 文档、issue、论坛等
- webfetch(HTTP 抓取)
- 通过 URL 拉 wiki 页面、接口文档、issue 页面等
👉 不配这个,它就看不到线上文档和实际接口。
- 通过 URL 拉 wiki 页面、接口文档、issue 页面等
你可以直接把结论记成一句话:
Coding Agent 的“物理上限”,是被这些工具硬性框住的。
不给看 CI 日志的工具,它就只能猜 CI;
不给查监控的工具,它就只能猜服务挂在哪。
2. 工具不只是“手”,也是“眼睛”:要有清晰反馈
很多 MCP 工具只负责执行动作,却不给结构化反馈,例如:
write_file:只说 “ok” 或 500 错误,没更多信息bash.run:给你几千行原始日志,模型还得在纯文本里找错误行
理想形态应该是:
{ "ok": false, "error_type": "SyntaxError", "file": "src/components/Button.tsx", "line": 42, "column": 13, "message": "Unexpected token '}'"}或至少:
ok: true/false- 清晰的
error_type(FileNotFound / PermissionDenied / RateLimit / SyntaxError …) - 必要的上下文(文件名、行号、命令、参数)
- 有时附一个
suggestion给 Agent 当 hint 用
工具不只是给 Agent 一双“手”,还要给它“眼睛”和“痛觉”。
只给命令、不给反馈,就是让 Agent 关着灯打怪。
3. 健壮性:自动分页等细活不要丢给模型
很多 API 都会分页:
{ "items": [...], "next_page_token": "abc123"}如果你原样给模型,让它自己:调第一页 → 看 token → 再调第二页 → 合并结果 → 处理边界……
理论上它可以;实际上:
- prompt 一长就忘
- 参数字段名写错、漏传 token 的概率极高
- 经常只看第一页就开始“下结论”
更合理的做法是:工具层负责自动分页。例如:
list_logs({ service, since, limit })- 内部自动翻页拿够
limit条结果 - 可以顺带给 summary:一共多少条 error / warn
- 内部自动翻页拿够
search_issues({ query, max_results })- 内部处理 pagination,把多页搜索结果拼成一个数组丢给模型
对 Agent 来说就变成了一句:
- 内部处理 pagination,把多页搜索结果拼成一个数组丢给模型
“我要最近 50 条 error 日志”,
而不是“你先拿第一页,再判断要不要拿第二页……”。
原则:能在工具里做的健壮性,就不要丢给模型推理。
模型擅长的是:理解、归纳、规划、决策;
不擅长的是:处理 next_page_token、边界条件、重试策略。
4. 代码编辑后,要自动触发“机器人的 LSP”
人写代码时很依赖:
- LSP / TS Server / eslint
- 编辑器里的红线 / 波浪线 / 悬浮提示
但对 Agent 来说:
- 它只知道“我刚刚
write_file/apply_patch了” - 它看不到 VS Code 里的红线
- 如果你不给它额外反馈,它只能“逻辑上觉得没问题”
正确的用法是:
不要只做“编辑工具”,
要做“编辑 + 检查一体化”的工具 / 流程。
例如:
apply_patch_and_check:- 输入:patch + 文件路径列表
- 内部流程:
- 应用 patch
- 跑一次
tsc --noEmit或等价 typecheck / lint - 收集 diagnostics(文件 / 行 / 列 / 消息)
- 返回:
ok: true/false- 若
false,附diagnostics数组
或者拆成两个独立工具:
edit_file/apply_patchrun_typecheck/run_lint
再在 AGENTS 的 SOP 里强制写上:
- 修改代码后,必须立刻跑一次检查工具
- 如果有错误,根据 diagnostics 再改
- 没错误再考虑跑测试
不要指望模型记得“改完要查飘红”,
也不要让它自己在五千行彩色日志里读错报错行。
5. 错误要“说人话”:清晰错误反馈比“失败了”重要多了
最烂的错误返回:
{ "ok": false, "error": "Something went wrong" }对人都没用,对模型更没用。
好一点的做法:
{ "ok": false, "error_type": "PermissionDenied", "message": "No permission to write /etc/config", "suggestion": "This path is system-level. Ask the user to execute this operation manually with sudo if necessary."}这样模型就能:
- 知道这是权限问题,不是“路径写错”
- 意识到“我重试 10 次也没用,不如 AskUserQuestion 问人”
6. 小结:好工具 = 能力 + 健壮性 + 反馈 + 传感器
一句 checklist 方便自查:
- 能干啥:文件 / bash / 搜索 / webfetch / LSP / CI … 能力边界清楚
- 怎么干得稳:自动分页、重试、超时、默认参数下沉到工具层
- 干完说清楚:结构化反馈(成功 / 失败 / 错误类型 / 位置 / 建议)
- 看到结果:通过 LSP / typecheck / lint 把“红线”显式暴露给模型
- 知道何时该问人:权限 / 风险 / 歧义类错误时,引导 Agent 走 AskUserQuestion
工具决定了模型的物理上限,
工具设计得好不好,决定了模型能不能摸到这个上限。
Skill:不是小工具,而是“可执行文件夹 + SOP”
在这里讨论的工作流中,Skill 不是一个“小 MCP 工具”,而更像是:
一整个可执行的文件夹:说明文档 + 操作步骤 + 可调用脚本。
1. Skill 的一种组织方式
一个典型 Skill 目录:
.agent/ skills/ ci-debug/ skill.md # 给模型看的 SOP / Prompt / 使用说明 run.sh # 真正执行诊断的脚本(模型可通过 bash 工具调用) parse_log.py # 日志解析脚本 examples.md # 示例输入输出,帮助模型理解用法特点:
- Skill 不是一开始就挂在主 Agent 的上下文里,而是“按需激活”:
- 当你调用这个 Skill 时,Agent 才把
skill.md拼进 Prompt; - 目录下允许调用的脚本,通过已有
bash/ 文件工具暴露给模型使用。
可以粗暴理解为:
- 当你调用这个 Skill 时,Agent 才把
MCP 工具回答“我能做哪些原子动作”;
Skill 回答“遇到这类问题,我按什么 SOP 来用这些动作”。
2. Skill vs MCP:流程化 vs 原子化
- MCP 工具:
- 通过工具定义暴露接口,可以一次加载,也可以按需发现,取决于 Harness
- 数量可能很多、质量参差不齐
- 描述更多是“这个工具干嘛”,很少说“在什么场景、按什么步骤用”
- Skill:
- 按需注入上下文(用到时才加载
skill.md) - 每个 Skill 是一个自带文档和脚本的小包:
- 有详细说明(skill.md)
- 有 bash / 脚本可以直接调用
- 有 examples 帮助模型理解输入输出形态
- skill.md 里可以写清楚:
- 步骤拆解(先 A 再 B 再 C)
- 什么时候应该调用 AskUserQuestion 问人
- 哪些脚本可以用、参数怎么填
使用场景:
- 按需注入上下文(用到时才加载
- “多一只手”——多几个原子动作 → 优先用 MCP
- 要把一整套经验 / 流程固化下来 → 做成 Skill 文件夹:
- CI debug
- MR review checklist
- 模块重构 SOP
- 安全扫描 / 依赖检查流程
3. Skill vs Sub Agent:可见的 SOP vs 独立执行
- Sub Agent:
- 一个完全独立的 Agent 会话:自己的 System Prompt / 上下文 / 工具集
- 主会话只看到“我给它任务 → 它给我结果”,主会话不必承载全部中间过程,详细轨迹可以单独记录
- 适合大块思考、长流程规划、报告撰写
- Skill:
- 在主会话里执行,步骤和脚本完全可见
- 有真实的目录结构,可版本管理、可审查、可复用
- 你可以给 Skill 整一个“文件夹”:可执行脚本 + 文档 + 示例
一句话:
想把“一个子任务整体包给另一个大脑”,用 Sub Agent;
想把“成熟打法”固化成 SOP + 脚本,让主 Agent 按流程执行,用 Skill。
大脑分工:sub agent 的隔离与并行
1. Sub Agent 的典型特征
再快速总结一下 Sub Agent:
- 独立的会话:自己的 System Prompt / 上下文 / 工具集
- 主 Agent 通常只看到输入和输出,不看到中间对话细节
- 上下文隔离:不会把内部的长对话 / 垃圾过程塞爆主上下文
- 可以并行:可以同时跑多个 Sub Agent,各自做一摊事,最后结果合并
适合这样的语境:
“你们仨各去看一个服务/方案,想一阵子,最后统一回来汇报。”
2. 典型例子:Explore 模式
比如很多 IDE / Code Assistant 里都有类似 “Explore” 的功能,大致是:
- 你发起一个 Explore:
- “帮我看看这个项目的登录流程大概怎么走?”
- “这个 user‑service 依赖了哪些外部系统?”
- 系统开启一个 Explore 子 Agent:
- 专属 System Prompt:“只读、不写,只做代码探索与说明”
- 工具集只包括
read_file/search,禁止修改文件、禁止危险 bash - 在自己的会话里疯狂读文件、做内部推理、整理结构
- 最后给主会话一份压缩好的结果:
- 登录流程说明
- 依赖关系概览
- 某个模块的语义总结
主 Agent 不知道 Explore 里面看了多少文件、跑了几轮推理,只拿到了结论。
更进一步,这完全可以 并行化:
- 有
auth-service、order-service、payment-service三个服务 - 起三个子 agent:Explore‑Auth / Explore‑Order / Explore‑Payment
- 它们各自只读自己的目录,各自写 summary(甚至写成 md 文件)
- 主 Agent 最后一轮统一读三份 summary,做整体决策(比如重构顺序)
3. 适合 Sub Agent 的任务类型
- 并行代码探索 / 盘点(多服务、多模块)
- 大规模配置 / 多环境对比(dev/staging/prod)
- 多方案并行论证(拆分方案 A/B/C,各自论证优劣)
- 长篇设计文档(Design Agent 专门写方案,不直接改代码)
这些任务的共性:
- 过程长、信息量大
- 需要隔离上下文,避免污染主对话
- 很适合并行,让多个子 agent 各做一摊,再汇总结果
4. Skill / Sub Agent / MCP 怎么配合?
可以用一张“心智图”记住它们的分工:
- MCP 工具:原子动作- Skill:可执行文件夹 + SOP(在主会话里跑,步骤可见)
- Sub Agent:独立大脑,可隔离可并行(在子会话里跑,结果回传)
实际设计 Agent 工作流时,一个很自然的组合是:
- 用多个 Sub Agent 并行做 Explore / 分析 / 设计
- 把结果写进 docs / state / spec 文件
- 在主会话里,用 Skill + 工具按 SOP 执行改动 / debug / 检查
- 关键岔路口用 AskUserQuestion 把你拉进来拍板
AskUserQuestion:把“我不确定,先问人”变成一等公民
1. 为什么需要允许模型表达不确定?
Why Language Models Hallucinate 讨论了一个重要机制:当训练与评测更奖励“猜一个答案”,而不是承认不确定时,模型可能给出看似合理却错误的回答。
这不能解释所有错误,但给工作流设计一个直接启发:信息不足时,系统要提供澄清和求助的路径,而不是只允许继续生成。
2. AskUserQuestion 工具:访问“人类”的接口
解决方案之一,就是在系统层补上一块:
把“问人”本身也变成一个工具:AskUserQuestion。
它的形态大概是:
- 模型调用
AskUserQuestion工具 - 参数里放要问你的问题(自然语言)
- Agent 在终端显示这个问题,等你输入回答
- 再把回答作为工具结果,喂回模型继续推理
典型适用场景:
- 需求不明确 / 有多个合理解释
- 文档相互矛盾 / 代码和注释打架
- 高风险操作(删库、改 schema、拆网关)前的最后确认
3. 在 Agent / Skill 设计里,把“能问就问”写进去
仅仅有 AskUserQuestion 还不够,要在 Agent / Skill 设计里把规则写死,比如:
- 在
AGENTS.md里写:- “当你对关键条件不确定时,请优先调用 AskUserQuestion,而不是自己做假设。”
- 在某些 Skill 的
skill.md里写:- “如果遇到权限问题 / 生产环境配置问题 / 多条相互矛盾的约定,
请调用 AskUserQuestion,请求人类确认。”
这样你等于在原来的“对/错评分”机制之外,
用工作流的方式再加上一条:
- “如果遇到权限问题 / 生产环境配置问题 / 多条相互矛盾的约定,
“不确定就问人”,是一个被鼓励的正确行为。
这也是“减少幻觉”的一个关键方向:
不仅是靠模型本身变强,还要靠 Agent / Skill / 工具 / HIL(Human‑in‑the‑loop)整体协作。
Spec Kit / DSL:用结构化需求降低“瞎猜空间”
再看一个常见需求:
agent "帮我写一个贪吃蛇小游戏"如果直接丢给模型,它要猜:
- 平台:web / terminal / mobile?
- 技术栈:React / Vue / 原生 / Canvas?
- 控制方式:键盘 / 触屏?
- 功能:记分、暂停、关卡、皮肤……?
熵非常高,自然容易瞎编。
更稳的方式是:
先一起把需求捏成一个 Spec 文件,再根据 Spec 写代码。
例如:
agent "我们先一起把贪吃蛇需求写成一个 spec.yaml,不要直接写代码"经过几轮问答/选项后,得到类似:
name: "Snake Game"project_type: "web"language: "TypeScript"framework: "React"rendering: "Canvas"grid: rows: 20 cols: 20control_scheme: "WASD"speed: "medium"features: - "score-board" - "pause" - "auto-restart"存成:
specs/snake-game.yaml之后所有相关任务,都指向它:
agent "根据 specs/snake-game.yaml,实现核心渲染和键盘控制逻辑"每次构造 Prompt 时,Agent 会把这份 Spec 读进上下文,让模型在一个已约束好的实现空间里搜索,而不是凭空想象。
Spec + AskUserQuestion 的组合大概是:
- Spec 负责把不确定项“显式暴露出来”
- AskUserQuestion 负责在关键字段填不满时,问你要真相
- 然后基于这个 Spec 做后续所有实现 / 测试 / 文档生成
Plan 模式 & Skill 模式:让 Agent 工作方式“可预测”
1. Plan 模式:慢就是快
针对项目情况识别需求
很多人用 Agent 修 bug 的时候是这样:
agent "帮我修一下 payment 模块的 bug,报错信息在某个 MR 的 CI 日志里"然后人和 Agent 一起在迷雾里乱跑,更稳的方式是:
- 先用 Plan 模式,让 Agent 帮你看清局面:
- “根据当前仓库和 issue,列出几类适合今天做的小任务,让我选一个”
- “为 healthz 这个需求写一份小 RFC,不要直接写代码”
- 你在 RFC 层面修改 / 确认完之后,再让它动手实现:
agent "现在按照这份 RFC,帮我在 user-service 里实现 /healthz,并补上测试。"Plan 的好处:
- 在 Spec / RFC 层先消灭歧义,再写代码,幻觉自然下降
- 你的意图变成一个文件,可复用、可 review,而不是飘在对话里
- 中间不确定点,可以统一通过 AskUserQuestion 暴露出来
2. Skill 模式:可执行 SOP,消灭重复工作
让重复工作不再发生
- 找到 mr -> 经过多层打开查看错误日志-> 滚动好久找到错误日志 -> 复制给模型
前面已经说了 Skill 的结构和定位,这里强调它对效率的贡献:
把“重复三次以上的流程”固化成 Skill:
- CI debug
- MR review checklist
- 模块重构步骤
- 安全扫描 / 依赖检查 / changelog 生成
你只需要:
agent "ci-debug mr-1234"- Skill 里包含:
- 文档(skill.md)
- 可执行脚本(run.sh / parse_log.py …)
- Skill 内部负责:
- 拉 CI 状态
- 定位失败 job
- 抽取关键日志
- 调用模型分析
- 在必要时 AskUserQuestion 让你拍板
结果是:
- 重复劳动被自动化
- Agent 的行为变得“有章可循、可审计”
- 幻觉空间被 SOP 和脚本硬生生压小了一大块
构建自己的工作流:从 .agent/ 到“插件化”
最后一块,是把这些东西变成 可分享的工作流。
1. 用 .agent/ 描述 Agent / Skill / Command
你可以在项目里约定一个配置目录:
.agent/ agents/ planner.yaml # 规划 Agent worker.yaml # 执行 Agent reviewer.yaml # 审查 Agent skills/ ci-debug/ # 一个完整 Skill 文件夹 generate-tests/ refactor-module/ commands/ migrate-payment.yaml# 支付迁移整套流程 fix-issue.yaml # 根据 Issue ID 修 bug 的流程agents/:不同角色的 Agent(planner / worker / reviewer),
定义它们的 System Prompt、默认工具集、AskUserQuestion 策略等skills/:一组可执行文件夹,每个里面有 skill.md + 脚本commands/:把多个 Agent / Skill 串成流水线,比如:migrate-payment:- 调 planner 生成/更新 plan
- 调多个 Sub Agent 并行 Explore 旧系统
- 用 worker 按 plan 执行迁移
- 用 reviewer 做审查
- 中间关键步骤通过 AskUserQuestion 拉你确认
以后你只要敲一行:
agent "migrate-payment 从旧网关迁到 v2 网关"背后执行的是你设计好的整套工作流,而不是“临时拍脑袋的 prompt”。
2. 打包成预设 / 插件,给别人用
当你把:
- AGENTS 宪法
- 一组成熟的 Agent 配置
- 多个 Skill 文件夹(CI / review / 重构 / 安全…)
- 若干 commands(迁移 / 修 bug / 探索 / 设计…)
打磨得差不多时,其实你已经做出了一个 团队级的 Agent 工作流预设。
下一步就是:
- 把
.agent/打包成一个模板 / 插件 - 放到团队内部或公开“市场”里
- 其他项目只要装上,就能直接复用你的整套工作流
从此:
“每个人自己写 prompt、自己踩坑”,
变成了
“团队 / 社区沉淀一套好用的 Agent 系统,一键复用”。
结语:从“用 Agent”到“设计 Agent + 工具 + 人的系统”
当你用 Coding Agent 时,你面对的已经不是一个“有点聪明的聊天机器人”,而是一套:
- 有物理边界:Transformer + KV Cache + Prompt Cache
- 有上下文结构:宪法区 / 过程区 / 短期记忆区
- 有工具:文件读写 / bash / 搜索 / webfetch / LSP / CI …
- 有分工:Agent / Sub Agent / Skill 各司其职
- 有人类参与:AskUserQuestion 把“我不确定,先问人”变成一等公民
- 有工作流:Plan / Spec / snapshot /
.agent// commands / 插件
的协作系统。
- Transformer + KV Cache 决定了“唯快不破”的物理约束;
- Prompt Cache 让稳定前缀变快、变便宜;
- 上下文管理(snapshot/spec/todo)让信息密度更高、噪音更少;
- 合适的工具集(File/Bash/Search/Webfetch + 良好反馈)拉高模型的物理上限;
- Sub Agent / Skill / Plan 模式,让复杂任务拆成多个“干净的小上下文”,还可以并行;
- AskUserQuestion / HIL 把“不确定时瞎编”改造成“不确定时先问人”;
.agent/下的配置,让你的经验可以沉淀、复用、分享。
当你开始按这个视角去思考和配置 Agent 时,你就不再只是一个 Agent 使用者,而是真正在 设计一套“模型 + 工具 + 人”的工程系统。